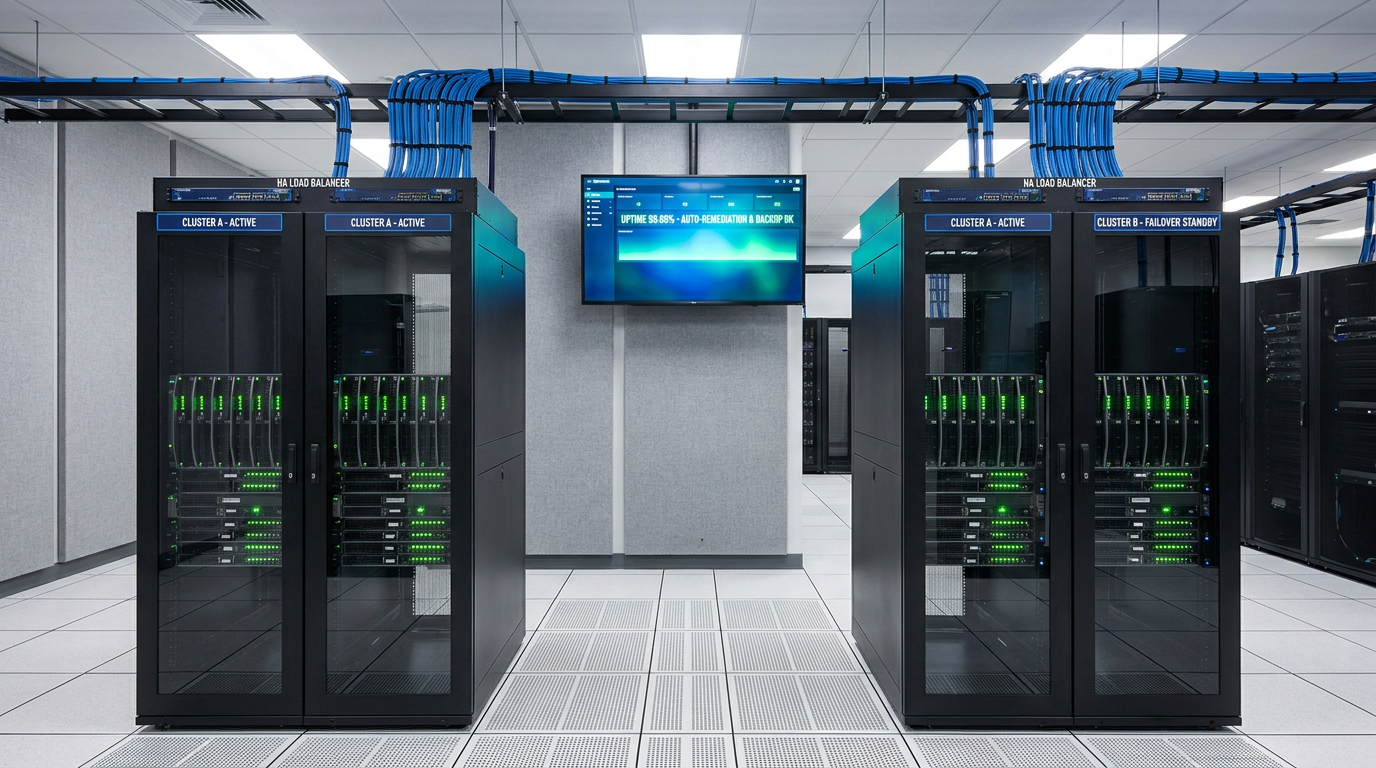
La mise en production initiale (Day-1) ne représente qu’une fraction du cycle de vie d’un système distribué. La véritable épreuve réside dans les opérations Day-2 : absorber les dégradations partielles, détecter les dérives silencieuses avant qu’elles n’affectent les utilisateurs, valider la restaurabilité réelle des sauvegardes et automatiser la remédiation sans déclencher d’effet cascade.
Une architecture à haute opérabilité remplace l’empilement d’alertes bruyantes par une boucle de rétroaction structurée mêlant tests canaries synthétiques, corrélation de signaux et auto-remédiation encadrée par validation humaine (Human-in-the-Loop).
1. Architecture de la boucle d’observabilité et de remédiation Day-2
Une supervision passive qui se contente de vérifier qu’un conteneur est Up ne détecte ni les impasses applicatives (deadlocks), ni l’expiration d’un jeton tiers, ni une corruption de cache. L’opérabilité moderne couple la télémétrie bas niveau avec des sondes fonctionnelles de bout en bout :

2. Les quatre niveaux de maturité opérationnelle Day-2
| Niveau d’opérabilité | Signal exploité | Temps de détection (MTTD) | Mode de résolution (MTTR) | Risque d’effet rebond |
|---|---|---|---|---|
| Niveau 1 : Réactif | Plaintes utilisateurs ou crash franc | 30 min à plusieurs heures | Diagnostic manuel à chaud en SSH | Élevé (modifications non tracées) |
| Niveau 2 : Monitoring infrastructure | Seuils CPU / RAM / Disque | 5 à 15 minutes | Alerte générique (fatigue d’alerte fréquente) | Moyen |
| Niveau 3 : Observabilité & Canaries | SLI/SLO + Tests fonctionnels continus | < 1 minute | Diagnostic pré-mâché avec contexte et logs corrélés | Faible |
| Niveau 4 : Remédiation gouvernée | Corrélation multi-signaux + Garde-fous | Temps réel | Auto-remédiation sur périmètre sûr + approbation 1-clic sur action critique | Très faible (circuit-breaker intégré) |
3. Pourquoi l’auto-remédiation aveugle est dangereuse (et comment la borner)
Redémarrer automatiquement un service ou purger une file d’attente dès qu’un seuil de latence est franchi peut transformer un ralentissement passager en panne globale (phénomène de Thundering Herd : perte des caches en mémoire, tempête de reconnexions SQL et saturation du CPU).
Pour qu’un moteur d’auto-remédiation soit fiable en production, il doit respecter trois garde-fous :
- Fenêtre de refroidissement (Cooldown & Rate-Limiting) : interdire plus d’une action corrective automatique par fenêtre de 15 minutes sur un même composant.
- Séparation stricte des actions par niveau d’impact :
- Classe A (Idempotente) : renouvellement de certificat, rotation de log, relance d’un worker isolé sans état.
- Classe B (Sous contrôle humain) : bascule DNS, redémarrage de base de données, purge de stockage ou déploiement correctif, soumis à validation explicite de l’opérateur avec bouton d’exécution et plan de rollback.
- Validation systématique par suite de non-régression : chaque action corrective déclenche immédiatement le banc de tests canaries pour prouver factuellement le retour au nominal.
4. Sondes d’intégrité et vérification continue des sauvegardes
Un système n’est résilient que si sa procédure de restauration est testée automatiquement. En opérations Day-2, le script de sauvegarde ne se termine jamais par un simple code retour 0 de copie : il vérifie la lisibilité des archives, la cohérence des sommes de contrôle et l’espace disque résiduel avant et après rotation.
| Commande | Description |
|---|

5. Synthèse architecturale
La résilience Day-2 ne repose pas sur l’absence de pannes, mais sur une architecture conçue pour être observable, prévisible et gouvernable sous contrainte. En associant des canaries de non-régression continus à une auto-remédiation supervisée par l’humain, l’infrastructure gagne en sérénité opérationnelle sans jamais sacrifier le contrôle.