Introduction
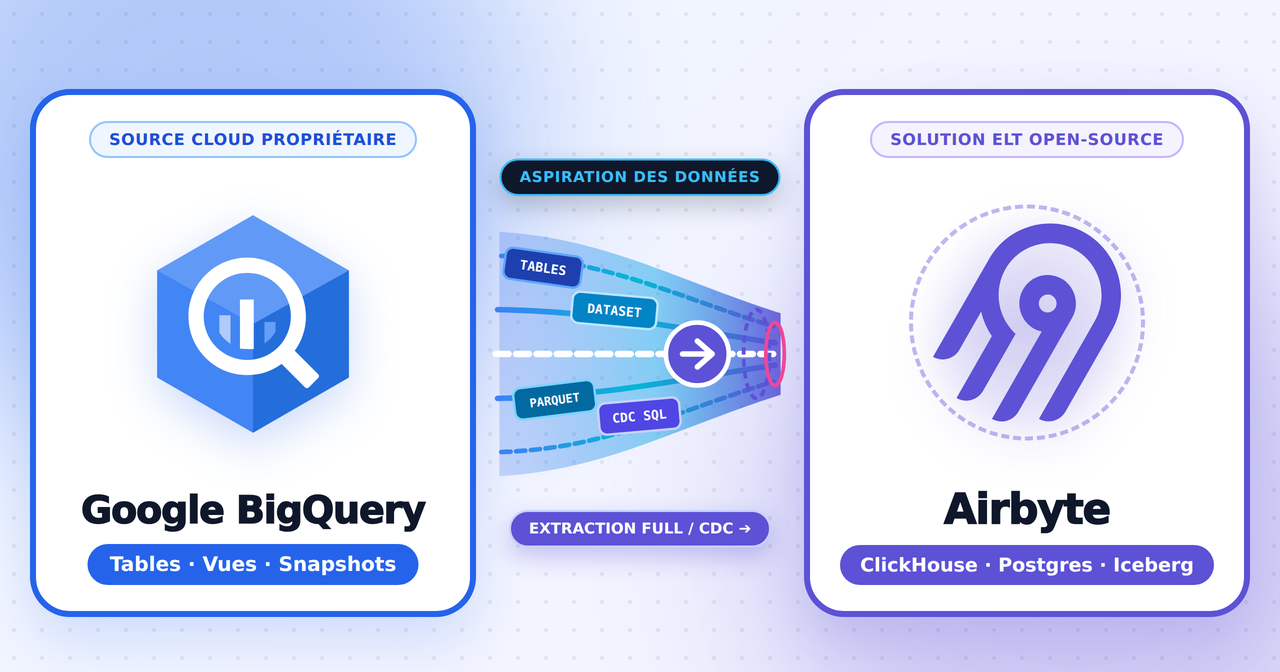
En épluchant différentes approches pour casser l’adhérence historique à Google Cloud Platform et plus particulièrement à BigQuery, je suis tombé sur le projet open source https://github.com/airbytehq/airbyte. BigQuery s’impose souvent par facilité initiale : zéro infrastructure à gérer, requêtes SQL distribuées à l’échelle du pétaoctet et intégration native à GCP. Mais la facturation au volume scanné, le stockage propriétaire et l’enfermement applicatif finissent vite par peser sur les coûts et la réversibilité.
Même sans l’avoir encore déployé en production intensive sur mes propres clusters, l’approche d’Airbyte offre une piste de sortie concrète : extraire les datasets BigQuery pour les répliquer vers des moteurs ouverts et auto-hébergés comme ClickHouse, PostgreSQL, MinIO ou Apache Iceberg.
Enfermement BigQuery et réponse ELT d’Airbyte
Quitter BigQuery exige de traiter bien plus que de simples tables plates : métadonnées, tables partitionnées, vues matérialisées, snapshots et types imbriqués (RECORD, ARRAY, JSON).
Plateforme ELT open source, Airbyte extrait les flux bruts sans imposer de transformation lourde en mémoire et délègue le traitement au moteur cible. Son connecteur source BigQuery lit nativement :
- Les tables standards, partitionnées et clustérisées.
- Les vues SQL classiques et matérialisées (Materialized Views).
- Les tables externes pointant sur Google Cloud Storage.
- Les snapshots temporels de tables.
Deux modes de synchronisation sont pris en charge : Full Refresh (écrasement ou ajout complet) et Incrémental (Incremental Append / Deduped), basé sur un curseur (updated_at, _PARTITIONTIME) pour n’extraire que le delta.

Déploiement local d’Airbyte Core et configuration de la source
Airbyte Core se déploie en local via Docker Compose (API, scheduler, workers de réplication et interface Web) :
# Récupération et lancement local d'Airbyte Core
git clone --depth=1 https://github.com/airbytehq/airbyte.git
cd airbyte
./run-ab-platform.sh

Sur http://localhost:8000, la source BigQuery requiert un Service Account GCP au moindre privilège :
roles/bigquery.dataViewersur le dataset à extraire.roles/bigquery.jobUsersur le projet exécutant les jobs d’export.
Payload JSON de déclaration de la source via l’API Airbyte :
{
  "name": "source-gcp-bigquery-prod",
  "workspaceId": "e2b6c7a1-31a8-48dc-9a84-18e42f2b3802",
  "configuration": {
    "project_id": "mon-projet-infra-prod",
    "dataset_id": "analytics_core",
    "credentials_json": "{\"type\": \"service_account\", \"project_id\": \"mon-projet-infra-prod\", \"private_key\": \"<REDACTED_GCP_SERVICE_ACCOUNT_PEM>\", \"client_email\": \"airbyte-extractor@mon-projet-infra-prod.iam.gserviceaccount.com\"}"
  }
}
Côté destination, parmi les 700+ connecteurs disponibles, ClickHouse reste la cible OLAP la plus efficace pour remplacer BigQuery à coût maîtrisé.
⚡ Update Novembre 2026 : Pilotage par les agents IA via le protocole MCP
*Mise à jour (Novembre 2026) : * Airbyte intègre désormais nativement le Model Context Protocol (MCP). Ce pont standardisé permet aux agents IA (Claude Desktop, Cursor, ChatGPT, VS Code Copilot) de piloter directement les pipelines ELT, d’inspecter les schémas et de diagnostiquer les échecs de réplication sans passer par l’interface graphique.
+------------------------------------------------------------------+
|                   Agent IA (Cursor / Claude / Copilot)           |
+------------------------------------------------------------------+
                                |  (Model Context Protocol)
                                v
+------------------------------------------------------------------+
|                     Airbyte MCP Gateway                          |
|  - Cloud : https://mcp.airbyte.com/mcp (OAuth)                   |
|  - Core  : Serveur MCP local pointant sur l'API Airbyte Core     |
+------------------------------------------------------------------+
                                |
                                v
+------------------------------------------------------------------+
|                   Airbyte Engine (Core / Cloud)                  |
|  - Lecture des logs de synchronisation                           |
|  - Déclenchement / Arrêt des jobs ELT                            |
|  - Détection des drifts de schéma BigQuery                       |
+------------------------------------------------------------------+
Configuration du serveur MCP
- Airbyte Cloud : connexion directe au point de terminaison
https://mcp.airbyte.com/mcpvia OAuth. - Airbyte Core (Self-Managed) : exécution locale du serveur
@airbyte/mcp-serverrelié à l’API REST Docker/Kubernetes :
{
  "mcpServers": {
    "airbyte-core": {
      "command": "npx",
      "args": [
        "-y",
        "@airbyte/mcp-server",
        "--api-url",
        "http://localhost:8001/api/v1",
        "--client-id",
        "airbyte",
        "--client-secret",
        "password"
      ]
    }
  }
}
Une simple requête en langage naturel suffit alors pour auditer un incident :
“Inspecte les logs du dernier échec BigQuery vers ClickHouse et identifie la colonne dont le type a divergé.”
L’agent appelle directement les primitives MCP (read_logs, list_streams, trigger_sync) et isole le drift de schéma.
Comparatif des destinations hors BigQuery
| Destination cible | Type de moteur | Cas d’usage principal | Mode de sync Airbyte recommandé |
|---|---|---|---|
| ClickHouse | OLAP orienté colonnes | Remplacement direct des requêtes analytiques BigQuery | Incremental Append + Dedup |
| MinIO / Ceph (S3) | Object Storage (Parquet) | Data Lakehouse ouvert (Trino / DuckDB) | Incremental Append |
| PostgreSQL | SGBD relationnel | Données agrégées et datamarts métier | Full Refresh Overwrite |
| Apache Iceberg | Format de table distribué | Archivage long terme et catalogue multi-moteurs | Incremental Append |
| Commande | Description |
|---|---|
git clone --depth=1 https://github.com/airbytehq/airbyte.git
| Cloner le dépôt Airbyte pour déploiement local |
./run-ab-platform.sh
| Démarrer les conteneurs Airbyte Core |
curl -u airbyte:password http://localhost:8001/api/v1/health
| Vérifier l'état de l'API Airbyte Core |
docker compose logs -f airbyte-worker
| Suivre les logs des workers d'extraction |
npx -y @airbyte/mcp-server --help
| Lister les options du serveur MCP pour agents IA |
docker compose down -v
| Arrêter et purger l'environnement local de test |
Conclusion
Airbyte fournit une passerelle standardisée et agnostique pour extraire les données de BigQuery vers des moteurs open source sans développer de scripts d’export sur mesure. La prise en charge complète des tables partitionnées, vues matérialisées et snapshots, complétée en novembre 2026 par le pilotage MCP pour agents IA, en fait un outil de référence pour préparer une sortie maîtrisée de GCP.
Si vous voulez plus d’information sur l’infrastructure vous pouvez voir mon repo à ce sujet : https://github.com/ravindrajob/InfraAtHome